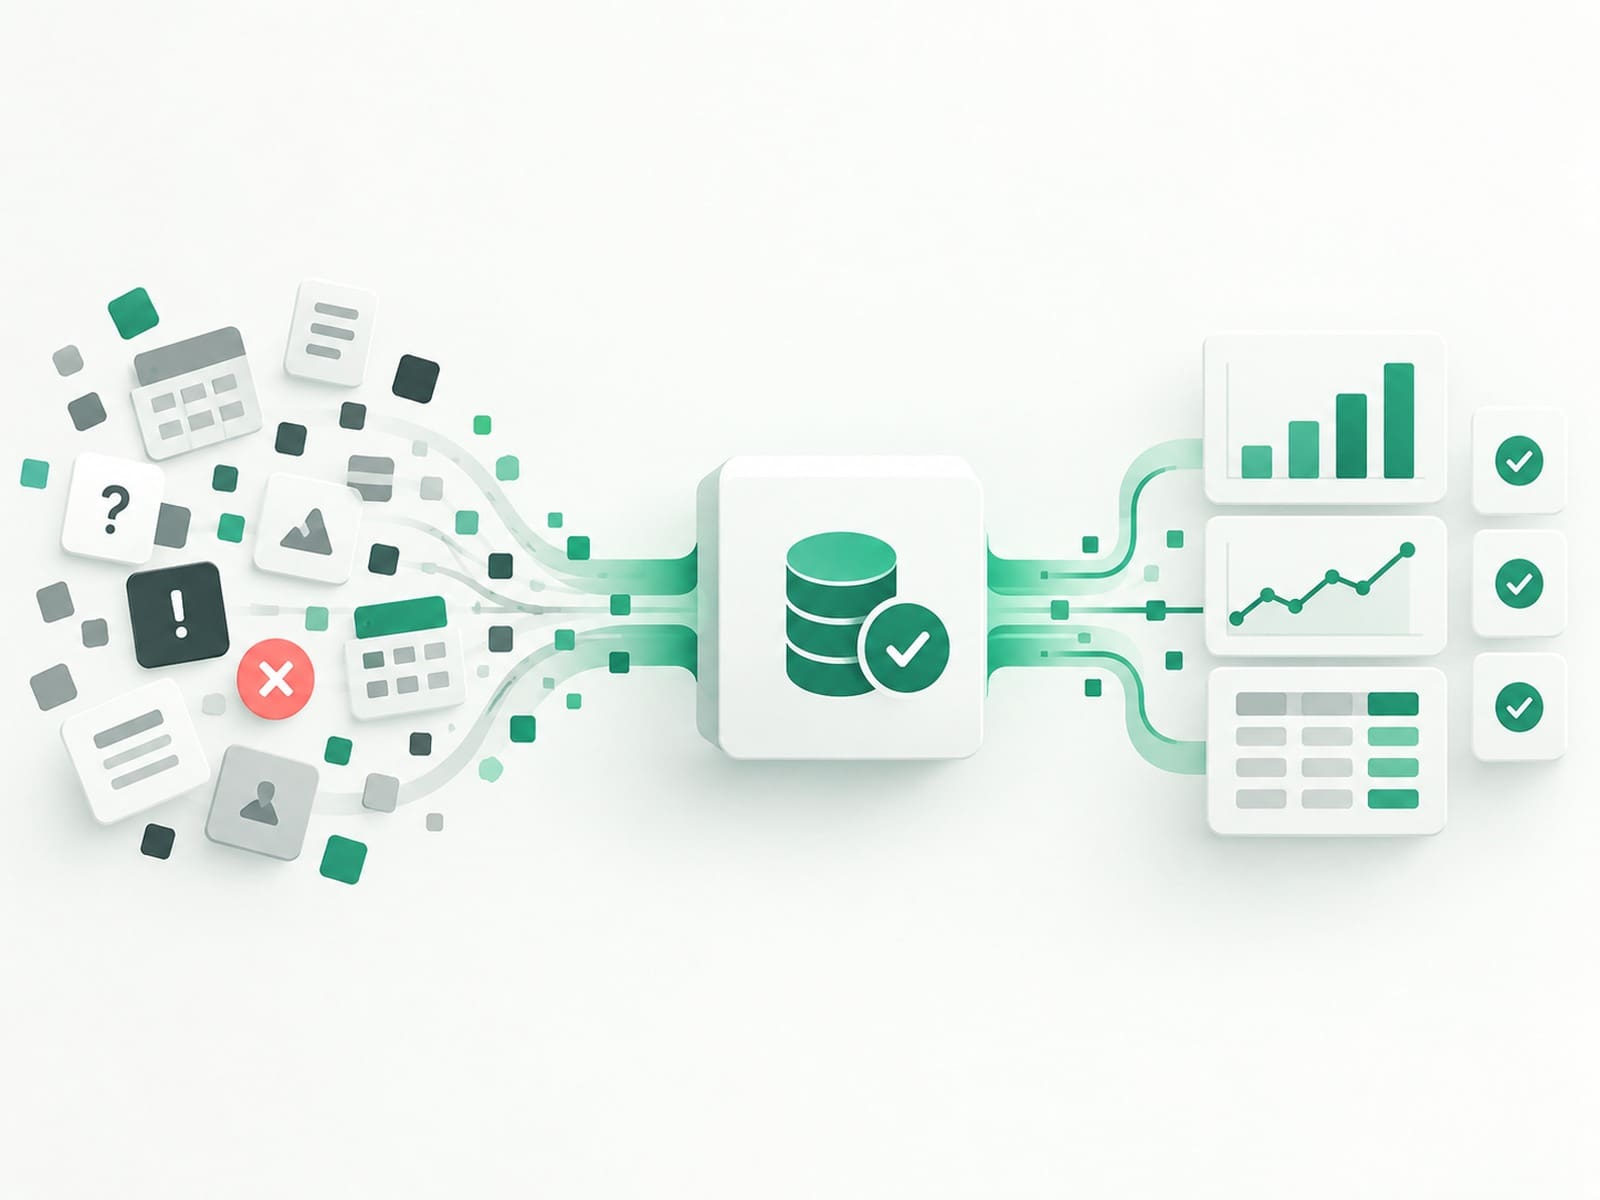
Datakwaliteit geeft aan in hoeverre data geschikt en betrouwbaar genoeg is voor het doel waarvoor je haar gebruikt.
Goede datakwaliteit betekent dus niet simpelweg dat alle data foutloos moet zijn. Het betekent dat de gegevens waarop je een beslissing baseert correct, volledig, actueel en eenduidig genoeg zijn om die beslissing verantwoord te kunnen nemen.
Dat maakt datakwaliteit veel meer dan een technisch onderwerp. Zodra mensen twijfelen aan cijfers, ontstaat er discussie over de data in plaats van over de beslissing die genomen moet worden.
Wat betekent datakwaliteit precies?
Data kan op verschillende manieren van onvoldoende kwaliteit zijn.
Een klantrecord kan bijvoorbeeld een verkeerd e-mailadres bevatten. Een order kan ontbreken in een rapportage. Twee systemen kunnen dezelfde KPI anders berekenen. Of de cijfers kunnen technisch correct zijn, maar pas drie weken later beschikbaar komen terwijl je er dagelijks op wilt sturen.
Dat zijn verschillende problemen, maar ze hebben allemaal hetzelfde gevolg: de data is minder bruikbaar voor het doel waarvoor je haar nodig hebt.
Bij datakwaliteit kijken we daarom meestal naar meerdere eigenschappen tegelijk.
- Juistheid: komt de data overeen met wat er werkelijk is gebeurd?
- Volledigheid: ontbreekt er belangrijke informatie?
- Consistentie: betekenen dezelfde gegevens in verschillende systemen hetzelfde?
- Actualiteit: is de data beschikbaar op het moment dat je haar nodig hebt?
- Validiteit: voldoet de data aan de afgesproken regels en definities?
- Uniciteit: worden dezelfde klanten, transacties of gebeurtenissen niet onbedoeld meerdere keren geteld?
Welke van deze eigenschappen het belangrijkst is, hangt af van de beslissing die je wilt nemen.
Datakwaliteit is altijd gekoppeld aan een doel
Een veelgemaakte fout is om over datakwaliteit te praten alsof data simpelweg goed of fout is.
In werkelijkheid hangt de benodigde kwaliteit af van waarvoor je de data gebruikt.
Voor een globale analyse van het websiteverkeer kan een kleine afwijking misschien nauwelijks relevant zijn. Maar wanneer dezelfde data wordt gebruikt om miljoenen euro’s marketingbudget te verdelen, kan diezelfde afwijking ineens wel belangrijk zijn.
Hetzelfde geldt voor actualiteit. Voor een jaarrekening kunnen maandelijkse cijfers voldoende zijn. Voor voorraadsturing in een webshop kan informatie van gisteren al te oud zijn.
De vraag is daarom niet alleen: klopt onze data? De betere vraag is: is onze data betrouwbaar genoeg voor de beslissing die we ermee willen nemen?
Een technisch correct cijfer kan nog steeds onbruikbaar zijn
Datakwaliteit gaat bovendien niet alleen over technische fouten.
Stel dat marketing rapporteert hoeveel leads er iedere maand binnenkomen. Technisch wordt iedere formulierinzending correct geregistreerd.
Maar wat is eigenlijk een lead?
Telt een sollicitatie ook mee? Een bestaande klant die een vraag stelt? Een dubbele aanvraag van hetzelfde bedrijf? Een aanvraag waarvan achteraf blijkt dat deze niet relevant was?
Als marketing en sales daar verschillende antwoorden op geven, kan de techniek perfect functioneren en kunnen de cijfers toch tot discussie leiden.
Goede datakwaliteit vraagt daarom niet alleen om betrouwbare systemen, maar ook om duidelijke definities en afspraken.
Datakwaliteit begint niet bij het oplossen van fouten
Wanneer organisaties problemen met data ontdekken, ontstaat al snel de neiging om losse fouten te repareren.
Een dashboard wordt aangepast. Een Excel-bestand wordt gecorrigeerd. Een trackingfout wordt opgelost.
Dat kan nodig zijn, maar het voorkomt niet automatisch dat hetzelfde probleem later opnieuw ontstaat.
Wij kijken daarom liever naar de hele keten achter een cijfer:
Definitie → verzameling → verwerking → opslag → rapportage → gebruik
Op ieder punt in die keten kan iets veranderen of misgaan.
Een website wordt aangepast waardoor een event niet meer wordt gemeten. Een veld in het CRM krijgt een andere betekenis. Een koppeling stopt met synchroniseren. Een transformatie in het datawarehouse wordt gewijzigd. Of iemand past de definitie van een KPI in één dashboard aan, maar niet in het andere.
Structurele datakwaliteit ontstaat daarom pas wanneer je niet alleen fouten herstelt, maar ook bewaakt of belangrijke data blijft voldoen aan de afspraken.
Waar ontstaan problemen met datakwaliteit?
Problemen kunnen vrijwel overal in de dataketen ontstaan. In de praktijk zien we een aantal oorzaken regelmatig terugkomen.
- Datacollectie: informatie wordt niet, dubbel of verkeerd geregistreerd.
- Handmatige invoer: velden worden verschillend ingevuld of helemaal overgeslagen.
- Koppelingen: data komt niet volledig of niet tijdig van het ene systeem in het andere terecht.
- Transformaties: berekeningen of selecties veranderen de oorspronkelijke data.
- Definities: teams gebruiken verschillende betekenissen voor dezelfde KPI.
- Wijzigingen: een aanpassing in een systeem heeft onverwachte gevolgen voor andere rapportages.
- Eigenaarschap: niemand voelt zich verantwoordelijk voor een bepaalde dataset of KPI.
Juist dat laatste wordt vaak onderschat. Een technisch probleem kan meestal worden opgelost. Maar wanneer niet duidelijk is wie bepaalt wat een cijfer betekent of wie reageert wanneer de kwaliteit verslechtert, blijft hetzelfde probleem terugkomen.
Goede datakwaliteit vraagt om monitoring
Je kunt de kwaliteit van belangrijke data niet één keer controleren en daarna aannemen dat alles blijft werken.
Digitale omgevingen veranderen voortdurend. Websites worden aangepast, CRM-processen wijzigen, nieuwe databronnen worden aangesloten en systemen krijgen updates.
Daarom is het verstandig om voor belangrijke data expliciet vast te leggen wat je verwacht.
- Welke gegevens moeten altijd binnenkomen?
- Welke waarden zijn wel en niet toegestaan?
- Hoe actueel moet de data zijn?
- Welke afwijkingen willen we automatisch signaleren?
- Wie is verantwoordelijk als er iets misgaat?
Daarmee verschuift datakwaliteit van periodiek fouten zoeken naar structureel bewaken.
En dat is belangrijk, want een fout die je snel ontdekt heeft vaak veel minder impact dan een fout die maandenlang ongemerkt in rapportages blijft zitten.
Moet data dan altijd perfect zijn?
Nee.
Perfecte data bestaat in de praktijk nauwelijks en proberen iedere mogelijke afwijking uit te sluiten kan meer kosten dan het oplevert.
Het gaat erom dat je weet welke data kritisch is voor belangrijke beslissingen en welk kwaliteitsniveau daarvoor nodig is.
Een organisatie hoeft dus niet ieder veld in ieder systeem tot op hetzelfde niveau te controleren. De aandacht hoort vooral te gaan naar de data waarop daadwerkelijk wordt gestuurd.
Goede datakwaliteit betekent niet dat je data perfect is. Het betekent dat je weet welke data je kunt vertrouwen, waarvoor je haar kunt gebruiken en wanneer je moet ingrijpen.
Hoe weet je of je datakwaliteit op orde is?
Kunnen we uitleggen waar onze belangrijkste cijfers vandaan komen?
Voor belangrijke KPI’s moet duidelijk zijn welke brondata wordt gebruikt en welke bewerkingen plaatsvinden voordat het cijfer in een rapportage verschijnt.
Gebruikt iedereen dezelfde definities?
Wanneer teams bijvoorbeeld verschillende definities van omzet, klant of lead gebruiken, kunnen technisch correcte rapportages toch verschillende antwoorden geven.
Merken we het als belangrijke data ontbreekt of verandert?
Goede datakwaliteit betekent ook dat afwijkingen tijdig zichtbaar worden. Zonder monitoring kan een fout lange tijd ongemerkt blijven bestaan.
Is onze data actueel genoeg voor de beslissingen die we nemen?
Niet iedere dataset hoeft realtime te zijn. Wel moet de beschikbaarheid passen bij het moment waarop de organisatie een beslissing moet nemen.
Is duidelijk wie verantwoordelijk is voor belangrijke data en KPI’s?
Er moet iemand kunnen bepalen wat een cijfer betekent en wie in actie komt wanneer de kwaliteit ervan verslechtert.
Weten we welke fouten daadwerkelijk impact hebben?
Niet ieder kwaliteitsprobleem is even belangrijk. De prioriteit hoort te liggen bij data die invloed heeft op belangrijke beslissingen, processen en resultaten.
Van cijfers hebben naar cijfers vertrouwen
Datakwaliteit is uiteindelijk geen doel op zichzelf.
Het doel is dat mensen binnen een organisatie hun tijd niet hoeven te besteden aan discussies over welk cijfer klopt, maar de beschikbare informatie kunnen gebruiken om betere beslissingen te nemen.
Dat vraagt om meer dan een eenmalige controle. Goede datakwaliteit ontstaat wanneer definities duidelijk zijn, belangrijke datastromen betrouwbaar zijn ingericht, afwijkingen tijdig worden gesignaleerd en duidelijk is wie verantwoordelijk is.
Pas dan ontstaat het vertrouwen dat nodig is om daadwerkelijk op data te sturen.
Lees ook: Wat is datagedreven werken?